Firma AssemblyAI wprowadziła STT-3.7, nowy model przetwarzania mowy na tekst, który zastępuje rodzinę Universal. Zapewnia on wsparcie dla większej liczby języków oraz poprawioną precyzję w identyfikacji mówców.
AssemblyAI wprowadziło model AssemblyAI-STT-3.7-Realtime-Agent, zaprojektowany specjalnie pod kątem interakcji z agentami głosowymi. Model ten rozwiązuje powszechne problemy w telefonicznej obsłudze klienta, takie jak oddzielanie głosu użytkownika od hałasu w tle oraz precyzyjne wyłapywanie danych, np. liczb, pod koniec wypowiedzi.
Firma AssemblyAI wprowadziła rodzinę modeli STT-3.7, obejmującą wersje dedykowane do nagrań, konwersacji na żywo oraz agentów głosowych. Jednocześnie zaprezentowano pierwszy silnik zamiany tekstu na mowę (TTS), zoptymalizowany pod kątem szybkich i naturalnych interakcji.
Firma AssemblyAI udostępniła aktualizację funkcji Medical Mode, zaprojektowaną w celu poprawy transkrypcji kluczowych terminów klinicznych, takich jak leki czy diagnozy. Aktualizacja ta redukuje liczbę błędów w nazwach leków o 30% w języku angielskim i do 62% w języku hiszpańskim, przy zachowaniu dotychczasowego poziomu wskaźnika błędów słownych (WER).
Google rozszerzyło swoją bibliotekę AI Edge o nowe możliwości rozpoznawania (ASR) i syntezy mowy (TTS) działające bezpośrednio na urządzeniu, bez konieczności połączenia z internetem. Deweloperzy mogą teraz integrować te wydajne modele za pomocą ML Kit dla Androida lub wieloplatformowego MediaPipe, wspierając ponad 100 języków przy wysokiej efektywności energetycznej.
AssemblyAI wprowadziło funkcję SpeakerRevision, która dostarcza poprawione etykiety mówców pod koniec strumienia na żywo. Wykorzystując kontekst niedostępny w trakcie przetwarzania real-time, osiąga dokładność na poziomie transkrypcji asynchronicznej, eliminując potrzebę utrzymywania podwójnych potoków przetwarzania.
Firma Gradium udostępniła Phonon, zestaw kompaktowych (65-75 MB) modeli zamiany tekstu na mowę, zaprojektowanych do pracy w całości na urządzeniach końcowych. Modele obsługują pięć języków, działają offline i oferują wydajność porównywalną z rozwiązaniami o znacznie większych rozmiarach.
Firma Cartesia wprowadziła dwa modele do zastosowań głosowych: Sonic (zamiana tekstu na mowę) oraz Ink (zamiana mowy na tekst). Zbudowane w oparciu o architekturę State Space Model (SSM), modele te zostały zaprojektowane z myślą o ultra-niskich opóźnieniach i wydajności w czasie rzeczywistym, co jest kluczowe dla profesjonalnych agentów głosowych.
AssemblyAI udostępniło Universal-3 Pro, wyspecjalizowany model zamiany mowy na tekst, który umożliwia programistom wydawanie poleceń bezpośrednio podczas procesu transkrypcji. Obsługuje transkrypcję dokładną (verbatim) oraz oczyszczoną, etykietowanie zdarzeń dźwiękowych i automatyczne przełączanie między sześcioma językami.
AssemblyAI wprowadziło AssemblyAI-TTS-1, model zamiany tekstu na mowę (TTS) stworzony dla agentów głosowych. Oferuje opóźnienia poniżej 100 ms, bibliotekę 4000+ głosów oraz natychmiastowe klonowanie głosu w cenie 15 USD za 1 mln znaków.
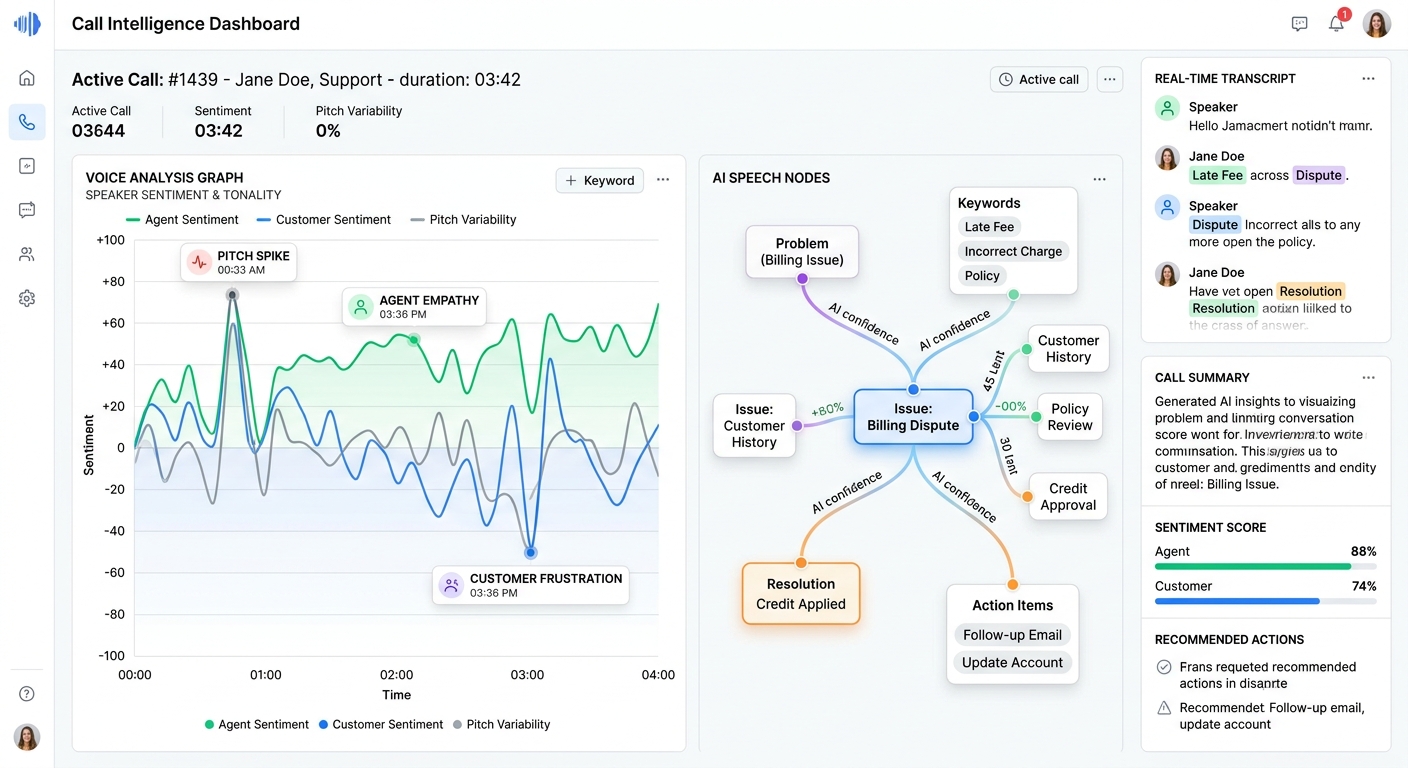
Uruchomiono platformę, która transkrybuje każdą rozmowę telefoniczną, ocenia ją według własnych kryteriów jakości Twojej firmy i przekłada wyniki na wskaźniki KPI konsultantów oraz plan coachingu. Łączy się z centralami 3CX, Asterisk, XCALLY, Genesys Cloud, Avaya i Cisco i obsługuje rozmowy po litewsku, łotewsku i angielsku.
Audible opracowało potok syntezy mowy (TTS), który wykorzystuje duże modele językowe (LLM) do profilowania postaci i przypisywania dialogów z dokładnością do 97%. Dzięki stosowaniu „wskazówek scenicznych” w formie opisów tekstowych, system zapewnia wyraźne i spójne głosy postaci w długich treściach audio.
AWS zaktualizował silnik generatywny Amazon Polly, zapewniając bardziej naturalną, ekspresyjną mowę oraz lepszą dokładność odczytu liczb, adresów i kodów potwierdzeń. Aktualizacja dodaje 14 nowych głosów w 9 lokalizacjach, zwiększając łączną liczbę do 57 głosów generatywnych w 11 językach i 25 lokalizacjach, w tym po raz pierwszy ogólnie dostępne głosy w języku hindi i fińskim. To aktualizacja typu drop-in: nazwy głosów, API i ceny pozostają bez zmian, więc istniejące aplikacje działają bez modyfikacji.
IBM wprowadził trzy aktualizacje rodziny Granite Speech: zupełnie nowy model mowa-język na 2B parametrów (granite-speech-5.0-2b), ulepszony model Turbo CTC na 470M parametrów nastawiony na szybkość oraz poprawiony model 4.1-2B-Plus dostosowany do nagrań z wieloma mówcami. Razem odpowiadają za wysoką dokładność transkrypcji/tłumaczenia, szybkie rozpoznawanie na urządzeniu oraz dokładne etykietowanie mówców i znaczników czasu. Wszystkie trzy pozostają na licencji Apache 2.0.
Mistral AI wydał Voxtral 3 – zestaw modeli rozpoznawania i syntezy mowy wraz z SDK, który w jednym potoku czasu rzeczywistego potrafi słuchać, wnioskować, wywoływać narzędzia i odpowiadać głosem. Modele rozpoznawania (Small, Mini i Realtime Transcribe 3) obsługują ponad 50 języków z rozróżnianiem mówców (diaryzacja), wzmacnianiem słów kluczowych dla słownictwa technicznego oraz opóźnieniem transkrypcji poniżej 500 ms, co według Mistral przewyższa Whisper, Scribe v2 i Gemini 3.5 Transcribe w ich testach. Model syntezy mowy Mini TTS 3 obsługuje ponad 35 języków i 50 dialektów z emocjami, tempem i akcentowaniem dostosowującymi się do kontekstu, w cenie 13 USD za milion znaków, a osobna funkcja Pro Voice potrafi odtworzyć głos i zakres emocjonalny osoby na podstawie zaledwie 30 minut nagrania. Wszystkie komponenty działają przez hostowane w UE API Mistral lub mogą być wdrożone na serwerach klienta.
AWS i Deepgram wspólnie przebudowały model rozpoznawania mowy Nova-3, aby działał natywnie na chipach Trainium2 zamiast standardowej infrastruktury PyTorch opartej na GPU, celując w duże zadania transkrypcji offline. Prace objęły przepisanie wąskich gardeł na własne kernele oraz zastąpienie warstwy serwującej Pythona środowiskiem uruchomieniowym w Rust, komunikującym się bezpośrednio z Trainium. Efekt: pojedyncza instancja trn2.3xlarge uruchamiająca osiem równoległych kopii modelu przetwarza 11-70% więcej dźwięku na dolara niż poprzednia infrastruktura Deepgram, a podobne oszczędności mogą być dostępne dla klientów samodzielnie hostujących rozwiązanie na SageMaker.