Firma Xiaomi wydała OmniBrain-0, kompaktowy model zaprojektowany do zunifikowanego sterowania robotami. Wykorzystuje on progresywne ramy szkoleniowe oraz mechanizm „Rubric-Guided Recursive Self-Improvement” do konsolidacji wiedzy eksperckiej w jeden wydajny model decyzyjny.
Deweloperzy mogą teraz egzekwować określone wytyczne dotyczące bezpieczeństwa treści bezpośrednio w zapytaniach API do modeli Grok. Dodając tablicę guidelines do zapytań Chat Completions lub Responses, można kontrolować sposób obsługi treści typu NSFW, przemocy oraz wulgaryzmów.
Google wprowadziło interfejs wiersza poleceń (CLI) dla Gemini API, zaprojektowany jako bezstanowe narzędzie bez zewnętrznych zależności dla programistów.
NVIDIA udostępniła CUDA 13.4, wprowadzając sprzętowo przezroczyste limity pamięci dla współdzielenia GPU. W połączeniu z nowym operatorem GPU Fractioning i KAI Scheduler v0.18.0, Twoja firma może definiować żądania pamięci, limity wzrostu oraz tryby obliczeniowe bezpośrednio w adnotacjach Podów Kubernetes.
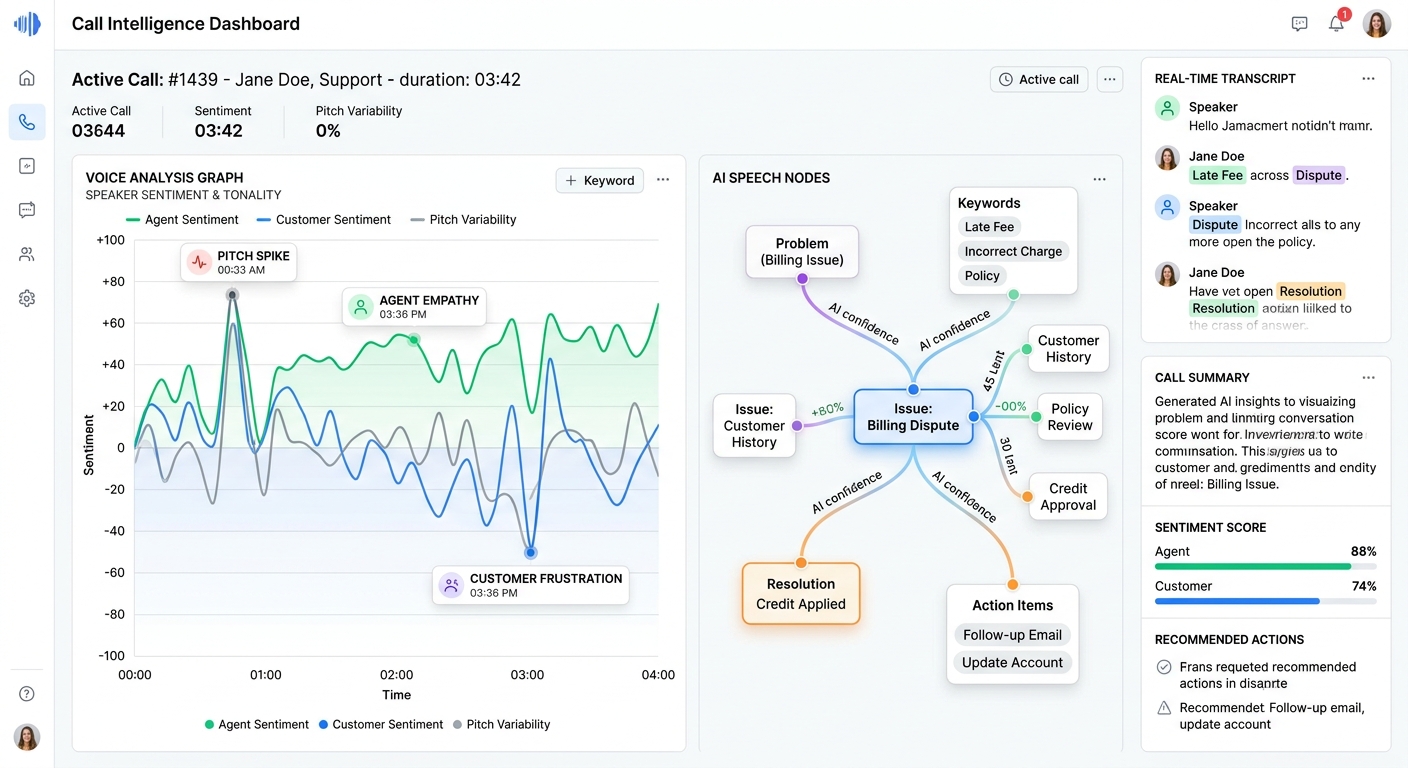
Uruchomiono platformę, która transkrybuje każdą rozmowę telefoniczną, ocenia ją według własnych kryteriów jakości Twojej firmy i przekłada wyniki na wskaźniki KPI konsultantów oraz plan coachingu. Łączy się z centralami 3CX, Asterisk, XCALLY, Genesys Cloud, Avaya i Cisco i obsługuje rozmowy po litewsku, łotewsku i angielsku.
Firma Mitsubishi Electric wydała aktualizacje bezpieczeństwa usuwające liczne luki w kilku produktach do automatyki przemysłowej, w tym w pakiecie GENESIS64 i ICONICS Suite. Usterki te mogą umożliwić atakującym wykonywanie dowolnego kodu, obejście uwierzytelniania lub wywołanie odmowy usługi (DoS).
Google Project Zero przeanalizowało porównanie systemów opartych na LLM (BigSleep) z tradycyjnymi fuzzerami generatywnymi (Fuzzilli) w kontekście wykrywania luk w silniku JavaScript V8. W ciągu sześciu miesięcy obie metody niezależnie odkryły unikalne błędy, przy szacowanym pokryciu wynoszącym od 25% do 60%.
Firma LiquidAI wprowadziła LFM3, nową generację małych modeli bazowych zbudowanych na wspólnym szkielecie 2B parametrów. Seria obejmuje modele tekstowe, wizyjne, audio i „omni”, zaprojektowane z myślą o wysokiej wydajności na urządzeniach końcowych.
NVIDIA udostępniła zbiory danych 'Nemotron-Personas' dla Francji i Belgii, mające na celu poprawę dokładności modeli LLM w odniesieniu do regionalnych procedur, demografii i niuansów kulturowych. Aktualizacja dostarcza kompletny przepływ pracy post-treningowej – w tym generowanie danych, dostrajanie LoRA przez NVIDIA NeMo oraz ewaluację – aby pomóc deweloperom przejść od modeli ogólnych do agentów specyficznych dla danej dziedziny.
Google DeepMind wprowadziło Genie 4, multimodalny model świata umożliwiający interaktywne symulacje w czasie rzeczywistym. Model natywnie generuje wideo, dźwięki otoczenia i responsywne dialogi, wykorzystując Gemini 3.8 Flash do utrzymania spójności fizycznej i złożonego wnioskowania.
Firma NVIDIA opublikowała strategię optymalizacji wnioskowania MoE, przetestowaną na modelu Ling-3.0-flash o 124 miliardach parametrów. Dzięki zastosowaniu specjalistycznych jąder Humming, precyzji FP8 dla LM head oraz predykcji wielu tokenów (MTP), można uzyskać wzrost przepustowości o 42,5% oraz redukcję opóźnień o 24,5%.
Firma Google zaktualizowała protokół generatywnego UI (A2UI), wprowadzając wymienne formaty wnioskowania (inference), aby rozwiązać problemy z opóźnieniami i niezawodnością występujące w poprzednim podejściu Direct JSON. Nowy format, A2UI Express, redukuje zużycie tokenów nawet 3-krotnie i opóźnienia nawet 3-krotnie, wykorzystując zwięzłą składnię w stylu Pythona.
Google wprowadziło Gemini Robotics Embodied Reasoning 2 (ER 2) w publicznej wersji zapoznawczej na platformie Gemini. Model ten pełni rolę zaawansowanej warstwy poznawczej dla robotyki, zdolnej do planowania, autokorekty zadań oraz zarządzania systemami wielorobotowymi za pomocą instrukcji w języku naturalnym.
NIST opublikował NISTIR 8547, czyli oficjalny przewodnik migracji do standardów odpornych na komputery kwantowe. Raport adresuje pilną potrzebę ochrony danych przed atakami typu „zbieraj teraz, odszyfruj później”, zgodnie z federalnymi wymogami dla systemów o wysokim priorytecie.
n8n 3.0 w wersji beta skupia się na stabilności architektury, zaostrzeniu domyślnych ustawień bezpieczeństwa i usunięciu starszych funkcjonalności. Wdrożenie modelu opartego wyłącznie na kontenerach (Docker) jest teraz obowiązkowe dla własnych instancji, a użytkownicy muszą skorzystać z wbudowanego raportu migracji, aby obsłużyć kluczowe zmiany przed grudniową premierą stabilnej wersji.
Naukowcy opracowali TraceQuery, framework rzadkiego (sparse) dekodowania, który redukuje koszty obliczeniowe dyfuzyjnych dużych modeli językowych (dLLM). Poprzez analizę trajektorii odszumiania, metoda selektywnie przelicza tylko niezbędne reprezentacje tokenów zamiast wykonywać zbędne operacje, zachowując wysoką dokładność przy mniejszym zapotrzebowaniu na moc obliczeniową.
Naukowcy przedstawili Boa Compressor, narzędzie typu online wykorzystujące model przestrzeni stanów Mamba do kompresji długiego kontekstu do krótszych reprezentacji w czasie liniowym. Dzięki destylacji wiedzy z pełnych interakcji LLM, metoda ta pozwala na wydajne wnioskowanie przy każdym zapytaniu, eliminując ogromne narzuty opóźnień typowe dla kompresji opartej na Transformerach.
Badacze opracowali metodę opartą na algorytmie k-center i wektorach (embeddings), która pozwala wybierać mniejsze, wysoce reprezentatywne podzbiory danych treningowych dla modelu Whisper. Podejście to przewyższa losowe próbkowanie dzięki lepszej reprezentacji różnorodności językowej, co jest szczególnie istotne przy ograniczonych zasobach.
Naukowcy wprowadzili Recursive Semantic Divergence (RSD) – nienadzorowaną metrykę, która mierzy i karze niespójność w trajektoriach działania agentów LLM. Stosując RSD jako sygnał nagrody podczas dostrajania (fine-tuning), modele wykazują znacznie bardziej stabilne zachowanie i wyższe wskaźniki sukcesu w zadaniach wykorzystujących narzędzia.
CISA oficjalnie uznała luki w PHP o oznaczeniach CVE-2026-109618 oraz CVE-2026-109619 za aktywnie wykorzystywane. Twoja firma powinna nadać priorytet ich naprawie, aby uniknąć potencjalnego przejęcia kontroli nad systemami.
Firma Cloudflare wykryła lukę bezpieczeństwa w silniku wnioskowania SGLang, która powodowała wyciek danych między zapytaniami użytkowników w modelu GLM-5.3. Zapytania przekraczające rozmiar skonfigurowanej pamięci podręcznej KV były błędnie przetwarzane, co prowadziło do generowania odpowiedzi na podstawie danych z sesji innych użytkowników.
Firma Apple zaprezentowała GHARP, nową metodę animowania ludzkich głów 3D w czasie rzeczywistym z wykorzystaniem dwuetapowego podejścia Gaussian Splatting. Dzięki rozdzieleniu statycznej rekonstrukcji tożsamości od lekkiego, zoptymalizowanego pod kątem urządzeń mobilnych przewidywania mimiki, model osiąga wiodące wyniki w benchmarku Ava-256 przy wysokiej wydajności obliczeniowej.
Google wprowadziło Gemini Omni, nowy model do generowania wideo, zdolny do tworzenia i edytowania klipów na podstawie wskazówek tekstowych i obrazów. Model ten stał się domyślnym rozwiązaniem dla procesów wideo w Google, a poprzedni model Veo został wycofany z API.
OpenAI oficjalnie udostępniło GPT-6.1 Terra, nowy model zaprojektowany specjalnie pod kątem rozumowania wizualnego, precyzyjnej obsługi komputera oraz generowania naturalnego tekstu.