„AssemblyAI“ išleido STT-3.7, naują kalbos į tekstą modelį, pakeičiantį „Universal“ šeimą. Jis pasižymi platesniu kalbų palaikymu ir žymiai tikslesniu kalbėtojų identifikavimu.
AssemblyAI išleido AssemblyAI-STT-3.7-Realtime-Agent – kalbos atpažinimo modelį, optimizuotą specialiai balso agentų veiklai. Jis skirtas spręsti tokias problemas kaip foninis triukšmas pokalbio metu ir svarbių duomenų, pavyzdžiui, skaičių, tikslus fiksavimas sakinio pabaigoje.
AssemblyAI išleido STT-3.7 modelių šeimą, skirtą įrašytam garsui, pokalbiams realiuoju laiku ir balso agentams. Be to, bendrovė pristatė savo pirmąjį teksto į kalbą (TTS) variklį, optimizuotą greitai ir natūraliai sąveikai pokalbių metu.
„AssemblyAI“ pristatė savo „Medical Mode“ funkcijos atnaujinimą, skirtą pagerinti itin svarbių klinikinių terminų, tokių kaip vaistų pavadinimai ir diagnozės, transkripciją. Šis patobulinimas 30 % sumažina praleistų vaistų pavadinimų skaičių anglų kalba ir iki 62 % – ispanų kalba, išlaikant bendrą žodžių klaidų rodiklį.
„Google“ išplėtė „AI Edge Gallery“ funkcijas, pridėdama balso atpažinimo (ASR) ir sintezės (TTS) galimybes įrenginiuose. Programuotojai dabar gali integruoti šiuos greitus, neprisijungus veikiančius modelius per „Android“ „ML Kit“ arba „MediaPipe Tasks“, kurie palaiko daugiau nei 100 kalbų ir užtikrina didelį energijos efektyvumą.
AssemblyAI pristatė „SpeakerRevision“ funkciją, kuri pateikia pakoreguotus kalbėtojų žymenis tiesioginės transliacijos pabaigoje. Naudojant kontekstą, kuris nebuvo prieinamas realiuoju laiku, pasiekiamas asinchroninio transkribavimo tikslumas, todėl nebereikia dubliuoti apdorojimo procesų.
„Gradium“ išleido „Phonon“ – kompaktiškų (65–75 MB) teksto į kalbą modelių rinkinį, skirtą veikti tiesiogiai vartotojo įrenginyje. Jis palaiko penkias kalbas, veikia be interneto ir demonstruoja rezultatus, prilygstančius gerokai didesniems modeliams.
„Cartesia“ pristatė du balso modelius: „Sonic“ (teksto pavertimas balsu) ir „Ink“ (balsas į tekstą). Sukurti naudojant būsenos erdvės modelio (SSM) architektūrą, šie modeliai yra skirti itin mažo vėlinimo, realaus laiko veikimui, tinkamam profesionaliems balso agentams.
„AssemblyAI“ išleido „Universal-3 Pro“ – specializuotą kalbos į tekstą (STT) modelį, leidžiantį kūrėjams pateikti instrukcijas tiesiogiai transkripcijos metu. Modelis palaiko tikslią (verbatim) ir tvarkingą (clean) transkripciją, pasirinktinių garso įvykių žymėjimą ir automatiškai perjungia šešias kalbas.
„AssemblyAI“ pristatė „AssemblyAI-TTS-1“ – tekstas-į-kalbą (TTS) modelį, optimizuotą balso agentams. Jis užtikrina mažesnį nei 100 ms vėlinimą, turi daugiau nei 4000 balsų biblioteką ir greitą balso klonavimą už 15 USD kainą už 1 mln. simbolių.
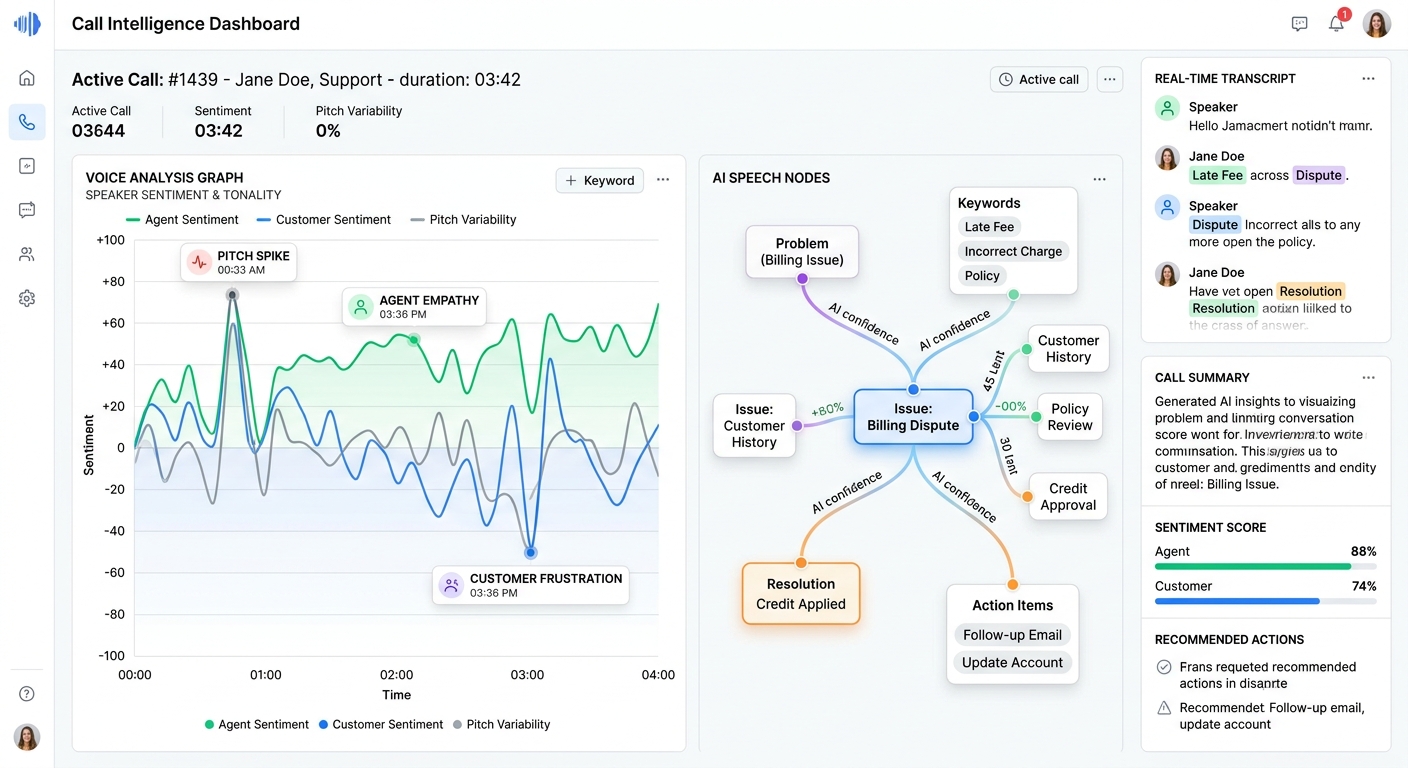
Pristatyta platforma, kuri transkribuoja kiekvieną telefono pokalbį, įvertina jį pagal pačios įmonės kokybės kriterijus ir paverčia rezultatus darbuotojų rodikliais bei ugdymo planu. Ji jungiasi prie 3CX, Asterisk, XCALLY, Genesys Cloud, Avaya ir Cisco telefonijos ir veikia su lietuviškais, latviškais ir angliškais pokalbiais.
„Audible“ sukūrė valdomą teksto į kalbą (TTS) sistemą, kuri naudoja didelius kalbos modelius (LLM) veikėjų profiliavimui ir dialogų priskyrimui su iki 97% tikslumu. Naudojant natūralios kalbos aprašymus kaip „scenos nurodymus“, sistema užtikrina išskirtinius ir nuoseklius veikėjų balsus viso ilgo formato turinio metu.
AWS atnaujino „Amazon Polly“ generatyvinį variklį – kalba tapo natūralesnė, išraiškingesnė ir tikslesnė skaitant skaičius, adresus bei patvirtinimo kodus. Atnaujinime pridėta 14 naujų balsų 9 lokalėse, iš viso dabar yra 57 generatyviniai balsai 11 kalbų ir 25 lokalėse, įskaitant pirmą kartą visuotinai pasiekiamus hindi ir suomių kalbos balsus. Tai „drop-in“ atnaujinimas: balsų pavadinimai, API ir kainodara nesikeičia, todėl esamos programos veikia be pakeitimų.
IBM pristatė tris „Granite Speech“ šeimos atnaujinimus: visiškai naują 2B kalbos-kalbos modelį (granite-speech-5.0-2b), patobulintą 470M „Turbo CTC“ modelį, skirtą greičiui, ir patobulintą 4.1-2B-Plus modelį, pritaikytą pokalbiams su keliais kalbėtojais. Kartu jie skirti tikslesnei transkripcijai/vertimui, greitam atpažinimui įrenginyje ir tiksliam kalbėtojų bei laiko žymių nurodymui. Visi trys lieka pagal Apache 2.0 licenciją.
Mistral AI išleido Voxtral 3 – kalbos atpažinimo ir kalbos sintezės modelių šeimą kartu su SDK, leidžiančiu vienoje realaus laiko grandinėje klausyti, mąstyti, iškviesti įrankius ir kalbėti. Atpažinimo modeliai (Small, Mini ir Realtime Transcribe 3) palaiko 50+ kalbų su kalbėtojų atskyrimu (diarizacija), raktažodžių paryškinimu techniniam žodynui ir mažesne nei 500ms delsa, kuri, anot Mistral, lenkia Whisper, Scribe v2 ir Gemini 3.5 Transcribe jų atliktuose testuose. Kalbos sintezės modelis Mini TTS 3 palaiko 35+ kalbas ir 50+ dialektų su emocijomis, tempu ir akcentavimu, prisitaikančiais prie konteksto, kainuojantis 13 USD už milijoną simbolių, o atskira funkcija Pro Voice gali atkurti žmogaus balsą ir emocinį diapazoną vos iš 30 minučių įrašo. Visi komponentai veikia per Mistral ES talpinamą API arba gali būti diegiami kliento serveriuose.
AWS ir Deepgram kartu perrašė Nova-3 kalbos atpažinimo modelį, kad jis veiktų tiesiogiai ant Trainium2 lustų vietoj įprastos GPU pagrįstos PyTorch infrastruktūros, orientuojantis į didelio masto nesinchroninius transkripcijos darbus. Darbo metu buvo perrašyti lėčiausi sluoksniai į individualius branduolius (kernels), o Python paslaugų sluoksnis pakeistas Rust laikomąja sistema, tiesiogiai kreipiantis į Trainium. Rezultatas: viena trn2.3xlarge instancija, vykdanti aštuonias lygiagrečias modelio kopijas, apdoroja 11-70% daugiau garso vienam doleriui nei ankstesnė Deepgram infrastruktūra, o panašus sutaupymas potencialiai pasiekiamas klientams, savarankiškai diegiantiems sprendimą per SageMaker.