NVIDIA pristatė CUDA 13.4, įdiegdama skaidrų atminties ribojimą GPU dalijimuisi. Kartu su nauju atvirojo kodo „GPU Fractioning Operator“ ir „KAI Scheduler“ v0.18.0, jūsų įmonė gali tiesiogiai „Kubernetes“ Pod anotacijose nustatyti konkrečius atminties poreikius, maksimalias ribas ir skaičiavimo režimus.
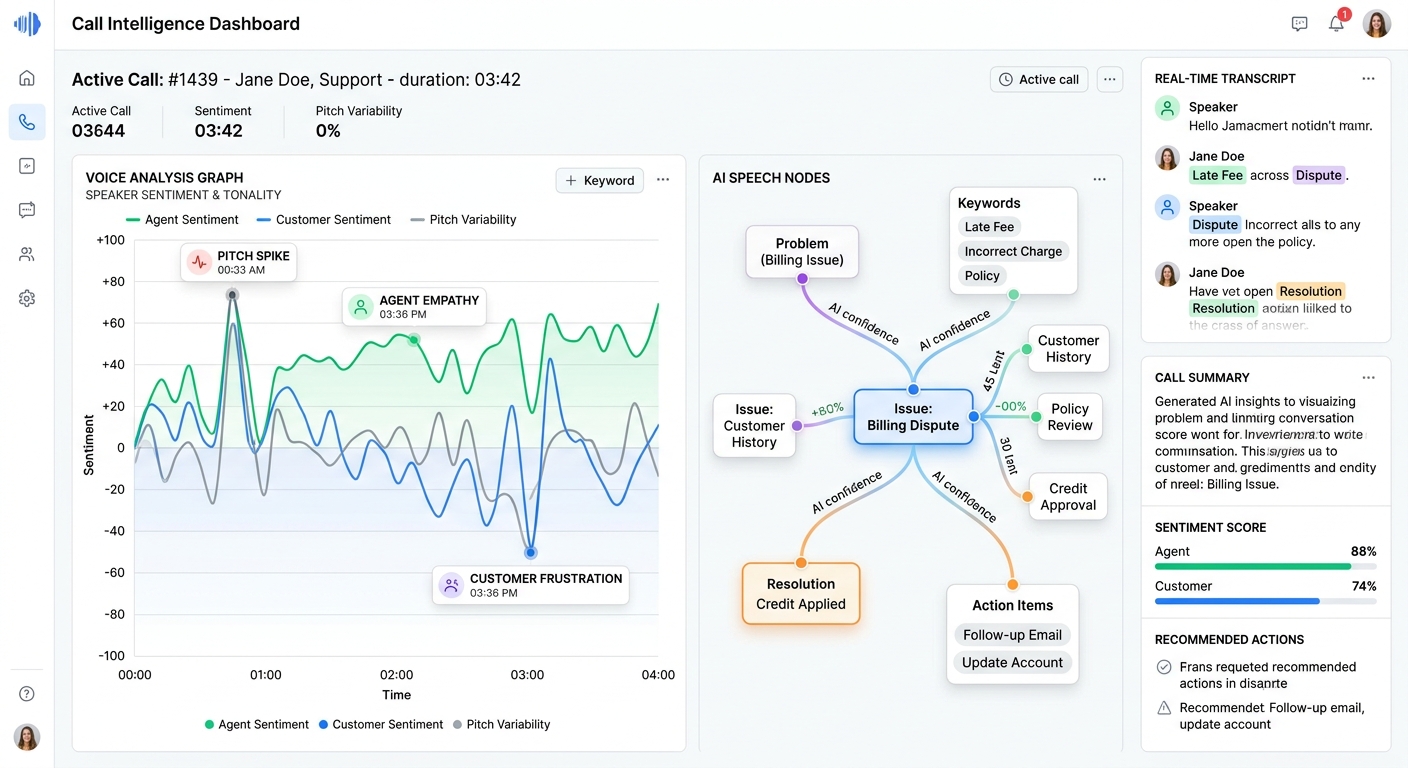
Pristatyta platforma, kuri transkribuoja kiekvieną telefono pokalbį, įvertina jį pagal pačios įmonės kokybės kriterijus ir paverčia rezultatus darbuotojų rodikliais bei ugdymo planu. Ji jungiasi prie 3CX, Asterisk, XCALLY, Genesys Cloud, Avaya ir Cisco telefonijos ir veikia su lietuviškais, latviškais ir angliškais pokalbiais.
„Mitsubishi Electric“ išleido saugos naujinius, skirtus pašalinti pažeidžiamumus keliuose pramoninės automatizacijos produktuose, įskaitant „GENESIS64“ ir „ICONICS Suite“. Šios klaidos gali leisti užpuolikams vykdyti savavališką kodą, apeiti autentifikavimą arba sukelti paslaugos trikdžius.
„Google Project Zero“ išanalizavo, kaip LLM pagrįstos sistemos (BigSleep) lyginasi su tradiciniais generatyviniais „fuzz“ įrankiais (Fuzzilli) ieškant V8 JavaScript variklio spragų. Per šešis mėnesius abu metodai savarankiškai aptiko unikalių klaidų, o jų sutapimas vertinamas tarp 25–60 proc.
„LiquidAI“ išleido „LFM3“ – naujos kartos mažus fundamentalius modelius, veikiančius bendrame 2B parametrų pagrinde. Seriją sudaro teksto, vaizdo, garso ir „omni“ modeliai, sukurti efektyviam veikimui tiesiogiai įrenginiuose.
NVIDIA išleido „Nemotron-Personas“ duomenų rinkinius Prancūzijai ir Belgijai, skirtus pagerinti LLM tikslumą regioninių procedūrų, demografijos ir kultūrinių niuansų atžvilgiu. Šis atnaujinimas suteikia pilną mokymo po pradinio treniravimo darbo eigą, įskaitant sintetinių duomenų generavimą, „LoRA“ derinimą per „NVIDIA NeMo“ ir vertinimą, padedantį pereiti nuo bendrųjų modelių prie konkrečiai sričiai skirtų agentų.
„Google DeepMind“ pristatė „Genie 4“ – multimodalinį pasaulio modelį, leidžiantį kurti interaktyvias simuliacijas realiuoju laiku. Jis natūraliai generuoja vaizdą, garsą ir interaktyvius dialogus, naudodamas „Gemini 3.8 Flash“ fiziniam nuoseklumui ir loginiam mąstymui užtikrinti.
„NVIDIA“ pristatė trijų dalių optimizavimo strategiją, skirtą pagreitinti MoE modelių išvedimą, išbandytą su 124 mlrd. parametrų „Ling-3.0-flash“ modeliu. Naudojant specializuotus „Humming“ branduolius, FP8 tikslumą „LM head“ sluoksnyje ir kelių žetonų prognozavimą (MTP), pralaidumą galima padidinti 42,5 %, o vėlinimą sumažinti 24,5 %.
„Google“ atnaujino savo A2UI generatyvinio UI protokolą, įtraukdama keičiamus išvadų (inference) formatus, taip spręsdama vėlavimo ir patikimumo problemas, susijusias su ankstesniu „Direct JSON“ metodu. Naujasis „A2UI Express“ formatas sumažina tokenų sunaudojimą iki 3 kartų ir delsą iki 3 kartų, naudodamas glaustą „Python“ stiliaus sintaksę.
„Google“ atvėrė viešąją „Gemini Robotics Embodied Reasoning 2“ (ER 2) versijos peržiūrą „Gemini“ platformoje. Šis modelis veikia kaip aukšto lygio kognityvinis robotikos sluoksnis, gebantis planuoti, savarankiškai taisyti užduočių eigą ir valdyti kelių robotų sistemas naudojant natūralios kalbos instrukcijas.
NIST išleido NISTIR 8547 – pagrindinį vadovą, skirtą perėjimui prie kvantiniams kompiuteriams atsparių standartų. Ataskaitoje akcentuojamas skubus poreikis apsaugoti duomenis nuo „rink dabar, iššifruok vėliau“ atakų, laikantis federalinių reikalavimų.
„n8n 3.0“ išleista beta versijoje, daugiausia dėmesio skiriant pagrindinės architektūros stabilumui, griežtesniems saugumo numatytiesiems nustatymams ir pasenusių funkcijų šalinimui. Nuo šiol savarankiškai talpinamoms sistemoms privalomas „container-only“ diegimo modelis, o prieš gruodžio mėnesį numatytą stabilų išleidimą naudotojai turi pasinaudoti integruota migracijos ataskaita (Migration Report) esamiems pokyčiams valdyti.
Tyrėjai sukūrė „TraceQuery“ – retų (sparse) dekodavimo karkasą, mažinantį difuzinių didžiųjų kalbos modelių (dLLM) skaičiavimo kaštus. Analizuojant triukšmo šalinimo trajektorijas, metodas selektyviai perskaičiuoja tik būtinas žetonų (token) reprezentacijas, užuot atlikęs perteklines operacijas, taip išlaikant aukštą tikslumą su mažesniais skaičiavimo resursais.
Tyrėjai pristatė „Boa Compressor“ – internetinį įrankį, naudojantį „Mamba“ būsenos erdvės modelį, kuris linijiniu laiku suspaudžia ilgą kontekstą į trumpesnes reprezentacijas. Išskirstant žinias iš pilno konteksto LLM sąveikų, šis metodas leidžia efektyviai atlikti išvadas kiekvienai užklausai be didelių „Transformer“ pagrįsto glaudinimo delsos sąnaudų.
Tyrėjai pasiūlė „k-center“ algoritmo metodą, pagrįstą įterpinių (embeddings) naudojimu, skirtą mažesniems, bet reprezentatyvesniems treniravimo duomenų rinkiniams parinkti. Šis metodas veikia geriau nei atsitiktinė atranka, nes užtikrina didesnę kalbinę įvairovę, ypač kai ribojami treniravimo ištekliai.
Tyrėjai pristatė „Recursive Semantic Divergence“ (RSD) – neprižiūrimą metriką, kuri matuoja ir baudžia už nenuoseklumą LLM agentų trajektorijose. Naudojant RSD kaip atlygio signalą tiksliojo derinimo (fine-tuning) metu, modeliai demonstruoja daug stabilesnį elgesį ir didesnius sėkmės rodiklius atliekant įrankių naudojimo užduotis.
„CISA“ oficialiai patvirtino, kad „PHP“ pažeidžiamumai CVE-2026-109618 ir CVE-2026-109619 yra aktyviai išnaudojami kibernetiniame erdvėje. Jūsų įmonė turėtų teikti prioritetą šių spragų šalinimui, kad išvengtų sistemos pažeidimų.
„Cloudflare“ nustatė SGLang išvedimo variklio saugumo klaidą, dėl kurios GLM-5.3 modelis atskleidė duomenis tarp skirtingų vartotojų užklausų. Užklausos, viršijusios sukonfigūruotą KV talpyklos dydį, buvo klaidingai apdorotos, todėl dekodavimo mazgas generavo atsakymus naudodamas senus kitų vartotojų duomenis.
„Apple“ pristatė GHARP – naują 3D žmonių galvų animacijos metodą, pagrįstą dviejų pakopų „Gaussian Splatting“ architektūra. Atskyrus statinį tapatybės atkūrimą nuo lengvo, mobiliesiems įrenginiams optimizuoto mimikos prognozavimo, modelis pasiekia aukščiausius rezultatus „Ava-256“ standarte išlaikydamas efektyvumą.
„Google“ pristatė „Gemini Omni“ – naują vaizdo įrašų generavimo modelį, gebantį kurti ir redaguoti vaizdo įrašus naudojant tekstines užuominas ar paveikslėlius. Šis modelis dabar yra numatytasis „Google“ vaizdo įrašų darbo eigoms, o ankstesnis „Veo“ modelis buvo pašalintas iš API.
OpenAI oficialiai išleido GPT-6.1 Terra – naują modelį, specialiai sukurtą vizualiniam argumentavimui, tiksliam kompiuterio valdymui ir natūralaus teksto generavimui.
„Amazon Bedrock“ dabar palaiko aiškų (explicit) ir numanomą (implicit) užklausų spartinimą (prompt caching) „OpenAI“ modeliams, leidžiantį saugoti ir pakartotinai naudoti statinius duomenis, tokius kaip įrankiai, instrukcijos ir pokalbių istorija. Išvengus identiškų žetonų pakartotinio apdorojimo, galite žymiai sumažinti įvesties kaštus ir pagerinti reagavimą sudėtingose agentų darbo eigose.
„Google Cloud“ išleido „IAM Helper“ – agentams skirtų komponentų rinkinį, skirtą sudėtingiems tapatybės ir prieigos valdymo (IAM) procesams automatizuoti. Naudodami MCP (Model Context Protocol), šie įrankiai leidžia autonominiams agentams spręsti problemas, pavyzdžiui, 403 klaidas, simuliuoti taisyklių poveikį ir prašyti laikinų prieigos teisių.
„NVIDIA“ išplėtė „Mission Control“ platformą, įtraukdama autonominio atkūrimo funkciją „Kubernetes“ aplinkoms, valdomoms per „Run:ai“. Sistema dabar atskiria užduočių atkūrimą nuo aparatinės įrangos priežiūros, leisdama tęsti mokymo procesus sveikuose mazguose, kol diagnozuojama sugedusi įranga.